Khai báo XML Sitemap, kiểm soát robots.txt và làm chủ Google Search Console sau ra mắt
Hướng dẫn kiểm tra XML Sitemap, robots.txt, chỉ thị noindex của WordPress, xác minh Google Search Console và đọc báo cáo URL Inspection sau khi ra mắt.
Mở cửa đón Googlebot bằng XML Sitemap chuẩn chỉnh và gỡ bỏ cái bẫy 'Discourage search engines' đúng lúc trên production, nhưng nhớ giữ chặt vòng kim cô noindex cho môi trường staging/lab để tránh cảnh bản nháp lên top Google trước cả web chính!
Phạm vi thực hành: Ubuntu 24.04 LTS trên VPS thử nghiệm độc lập; tên miền lab lab-cf02.localhost.vn. Chỉ thao tác trên tài sản do chính bạn quản lý. Phiên rà soát trên máy chủ LAB-CF-02 lúc 00:02–00:03 ngày 01/10/2026 (UTC+7) xác nhận trạng thái khóa chỉ mục (noindex), tập tin robots.txt và tính năng sitemap đang tắt theo đúng chủ đích bảo vệ môi trường thử nghiệm. Phiên thực nghiệm độc lập lúc 09:09 ngày 02/10/2026 trên bản clone nội bộ (loopback) đã kích hoạt và kiểm chứng cấu trúc XML Sitemap hoạt động chuẩn xác trong khi vẫn giữ nguyên lớp chắn noindex, sau đó hoàn nguyên sạch sẽ. Riêng phần thực hành với Google Search Console được ghi nhận thực tế trên hệ thống sản phẩm (production) localhost.vn vào buổi chiều ngày 02/10/2026; tuyệt đối không khai báo đường dẫn của môi trường lab lên Google.
Trong giới làm web và SEO, có hai tai nạn trái ngược nhau nhưng độ sát thương thì một chín một mười: tai nạn thứ nhất là dựng xong website chính thức hoành tráng, viết bài mỏi tay suốt 3 tháng trời mà quên bỏ dấu tích “Chặn công cụ tìm kiếm” từ thời làm bản nháp, khiến Google đi ngang qua chỉ biết đứng ngoài nhìn mà không dám bước vào; tai nạn thứ hai là quên khóa noindex cho máy chủ thử nghiệm (staging/lab), để rồi một sáng đẹp trời khách hàng gõ tên thương hiệu trên Google lại thấy… trang web nháp toàn chữ Lorem ipsum chễm chệ trên Top 1! Bộ ba công cụ XML Sitemap, robots.txt và Google Search Console (GSC) chính là bảng điều khiển trung tâm giúp bạn chỉ đường dẫn lối cho bọ tìm kiếm (Googlebot) biết trang nào nên đọc, trang nào nên né và theo dõi sát sao sức khỏe lập chỉ mục (indexing) của website. Tất nhiên, bộ công cụ này đóng vai trò khai báo kỹ thuật chứ không phải chiếc đũa thần thay thế chất lượng bài viết hay cam kết 100% cứ gửi lên là lên Top ngay lập tức. Quy trình dưới đây dành cho website chính thức đã sẵn sàng bước ra ánh sáng, đồng thời chỉ rõ cách giữ cho môi trường lab nằm ngoài vùng phủ sóng của công cụ tìm kiếm.
Xác định rõ biên giới tài sản: Đâu là Production cần Index, đâu là Lab cần ẩn mình?
Trước khi mở Google Search Console, bạn hãy viết rõ ra giấy định dạng URL chuẩn (Canonical URL) của website chính thức: dùng giao thức https://, thống nhất phiên bản có www hay không có www, và có nằm trong thư mục con nào hay không. Hãy mở trình duyệt ở chế độ khách ẩn danh để dạo một vòng xem các trang đã truy cập mượt mà chưa và có còn sót bài viết nháp nào từ lúc test không. Những tên miền phục vụ diễn tập kỹ thuật như lab-cf02.localhost.vn sinh ra chỉ để làm phòng thí nghiệm, tuyệt đối không bao giờ đem đi khai báo hay quảng bá trên Google.
Mọi thao tác xác minh tên miền và gửi sơ đồ trang web chỉ được thực hiện bởi chủ sở hữu hợp pháp hoặc kỹ thuật viên được ủy quyền. Trong bài viết này, bạn sẽ thấy sự phân vai rất rõ ràng: các bước kiểm tra cài đặt Reading, robots.txt và cấu trúc XML Sitemap ở môi trường đóng được thực hiện trên LAB-CF-02; còn toàn bộ quy trình xác minh quyền sở hữu bằng DNS TXT, nộp Sitemap và dùng công cụ URL Inspection ở cuối bài được thực hiện trực tiếp trên hệ thống sản phẩm thật là localhost.vn. Việc website chính thức được Google lập chỉ mục hoàn toàn tách biệt với môi trường lab.
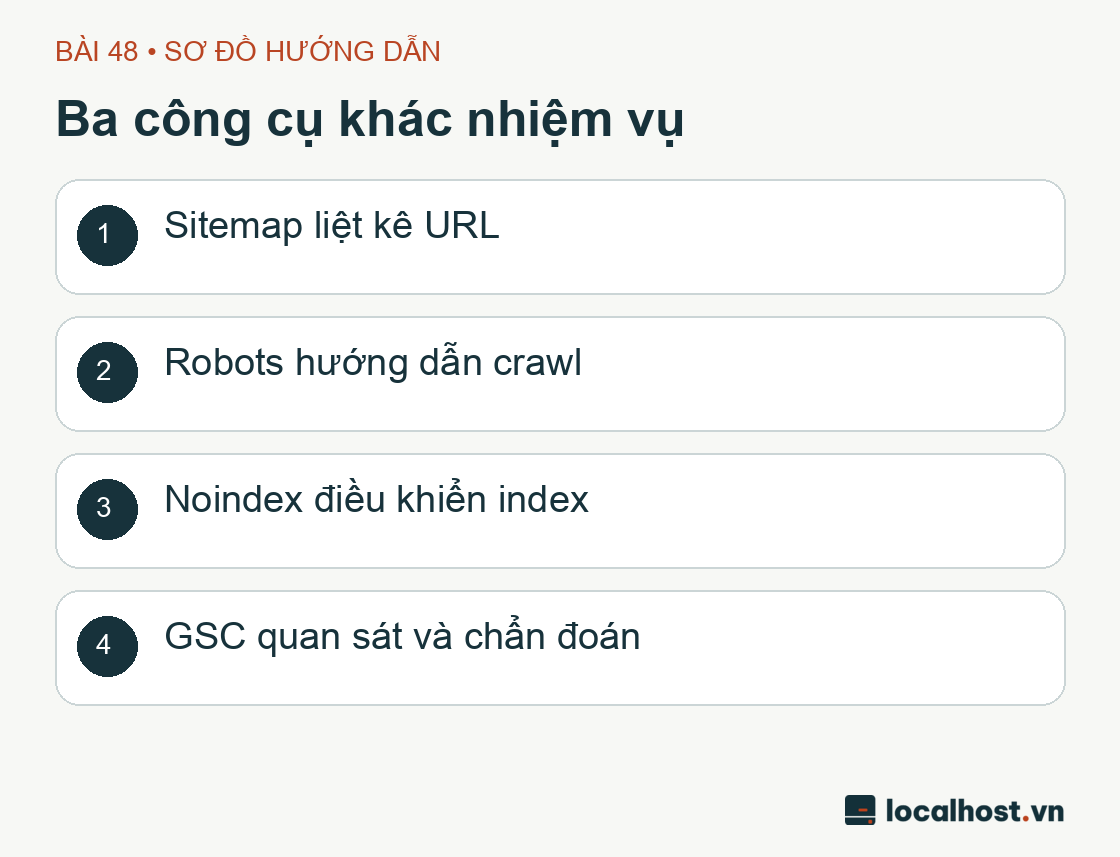
Sơ đồ ba công cụ khác nhiệm vụ: Sitemap liệt kê URL; Robots hướng dẫn crawl; Noindex điều khiển index; GSC quan sát và chẩn đoán
Sơ đồ phân biệt vai trò của Sitemap, Robots.txt, chỉ thị Noindex và Google Search Console do localhost.vn biên soạn để minh họa nguyên lý, không phải ảnh chụp từ môi trường lab.
Bước 1: Kiểm tra “Công tắc tử thần” trong mục Settings → Reading của WordPress
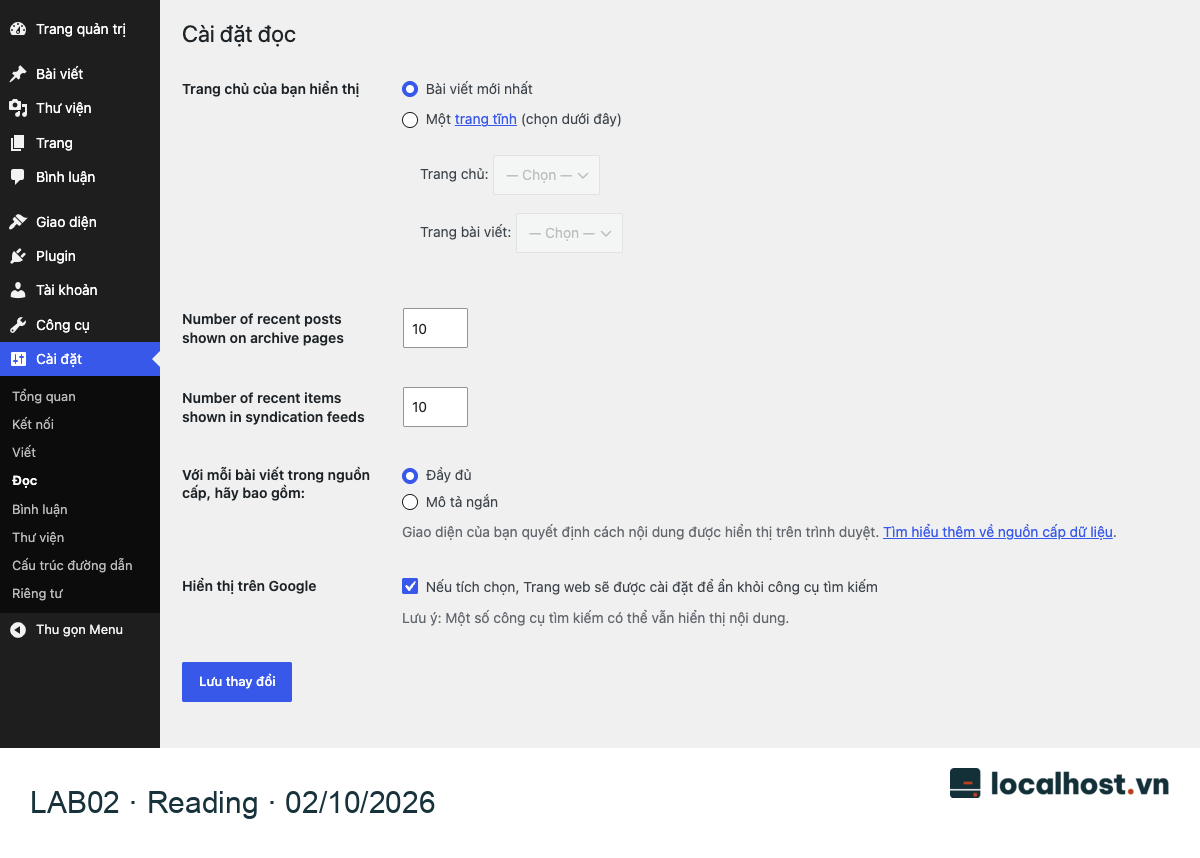
Ngay sau khi bàn giao hoặc mở cửa website, nơi đầu tiên bạn phải ghé thăm là Settings → Reading (Cài đặt → Đọc) trong trang quản trị WordPress để nhìn tận mắt ô tùy chọn Discourage search engines from indexing this site (Ngăn chặn công cụ tìm kiếm lập chỉ mục trang web này). Nếu đây là website chính thức (production) đã sẵn sàng đón độc giả từ Google, hãy đảm bảo ô vuông này được bỏ trống (unchecked). Ngược lại, nếu đây là máy chủ thử nghiệm (staging/lab), hãy tích chọn (checked) nó thật chặt! Ngoài công tắc tổng này, nếu website có cài đặt các plugin hỗ trợ SEO (như Yoast SEO, Rank Math hay SEOPress), bạn nhớ rà soát thêm cả phần thiết lập của plugin vì chúng có khả năng gắn thẻ noindex riêng lẻ cho từng bài viết hoặc từng chuyên mục.
Ảnh chụp giao diện thực tế lúc 07:57 sáng ngày 02/10/2026 (giờ Việt Nam) trên máy chủ LAB02. Trong bản dịch giao diện tiếng Việt của WordPress, mục này mang nhãn “Hiển thị trên Google” và ô “Ngăn chặn các công cụ tìm kiếm…” đang được tích chọn đúng chuẩn môi trường thử nghiệm. Chúng tôi chỉ mở màn hình để quan sát và chụp ảnh đối chiếu chứ không bấm thay đổi cấu hình. Ảnh được giữ nguyên độ phân giải pixel gốc kèm chân trang logo; bấm vào ảnh để xem kích thước đầy đủ.
Có một sự thật phũ phàng về bảo mật mà bạn phải luôn khắc cốt ghi tâm: ô tùy chọn trong mục Reading hay tập tin robots.txt hoàn toàn không phải là chiếc ổ khóa bảo mật! Chúng chỉ giống như tấm biển lịch sự treo trước cửa viết dòng chữ “Xin các anh bọ tìm kiếm đứng ngoài đừng chụp ảnh”; những con bọ ngoan ngoãn như Googlebot sẽ tôn trọng và quay lưng đi, nhưng bất kỳ người dùng nào biết đường dẫn URL hoặc các trình quét dữ liệu ác ý (bad bots) vẫn có thể đi thẳng vào đọc toàn bộ nội dung nếu máy chủ của bạn mở công khai trên Internet. Vì vậy, đối với các dữ liệu nội bộ nhạy cảm hay các bản sao lưu (backup), bạn bắt buộc phải khóa bằng mật khẩu xác thực (như HTTP Basic Auth) hoặc giới hạn IP ở tầng web server. Xem thêm tài liệu chính thức tại WordPress Documentation: Settings Reading Screen.
Bước 2: Xác định đúng đường dẫn XML Sitemap thực tế của Website
Đừng bao giờ nhắm mắt đoán mò đường dẫn sitemap rồi gửi đại lên Google Search Console! Kể từ phiên bản 5.5 trở đi, bản thân lõi WordPress (WordPress Core) đã tự động tích hợp sẵn tính năng tạo sơ đồ trang web tại đường dẫn mặc định là /wp-sitemap.xml. Tuy nhiên, nếu bạn cài thêm các plugin SEO chuyên dụng, chúng thường sẽ tự động tắt sitemap mặc định của lõi đi và thay thế bằng đường dẫn riêng (chẳng hạn như /sitemap_index.xml). Hãy dùng lệnh curl -I dưới đây để thăm dò phản hồi thực tế trước:
curl-I https://TEN-MIEN-CUA-BAN/wp-sitemap.xml
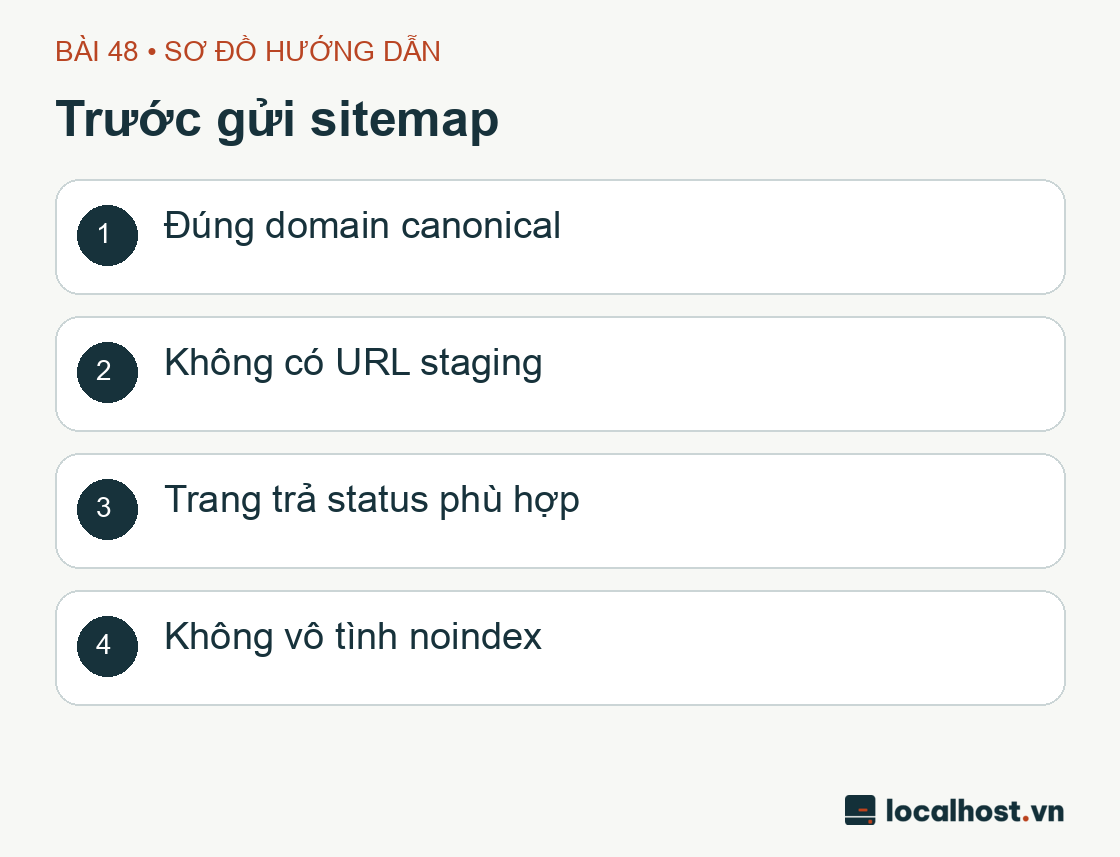
Bạn hãy thay thế phần tên miền mẫu bằng tên miền chính thức của mình rồi mở trực tiếp đường dẫn sitemap đó trên trình duyệt web. Từ trang sơ đồ tổng (sitemap index), hãy bấm mở thử một vài sơ đồ con (sub-sitemaps) bên trong và kiểm tra ngẫu nhiên một vài URL bài viết. Một bản XML Sitemap khỏe mạnh phải thỏa mãn 4 tiêu chí: mọi đường dẫn bên trong đều mang đúng giao thức https:// và tên miền chuẩn (canonical domain), tuyệt đối không lẫn lộn đường dẫn của máy chủ nháp (staging), các URL khi bấm vào đều trả về mã 200 OK thay vì lỗi 404, và không chứa những trang đang bị gắn nhãn noindex.
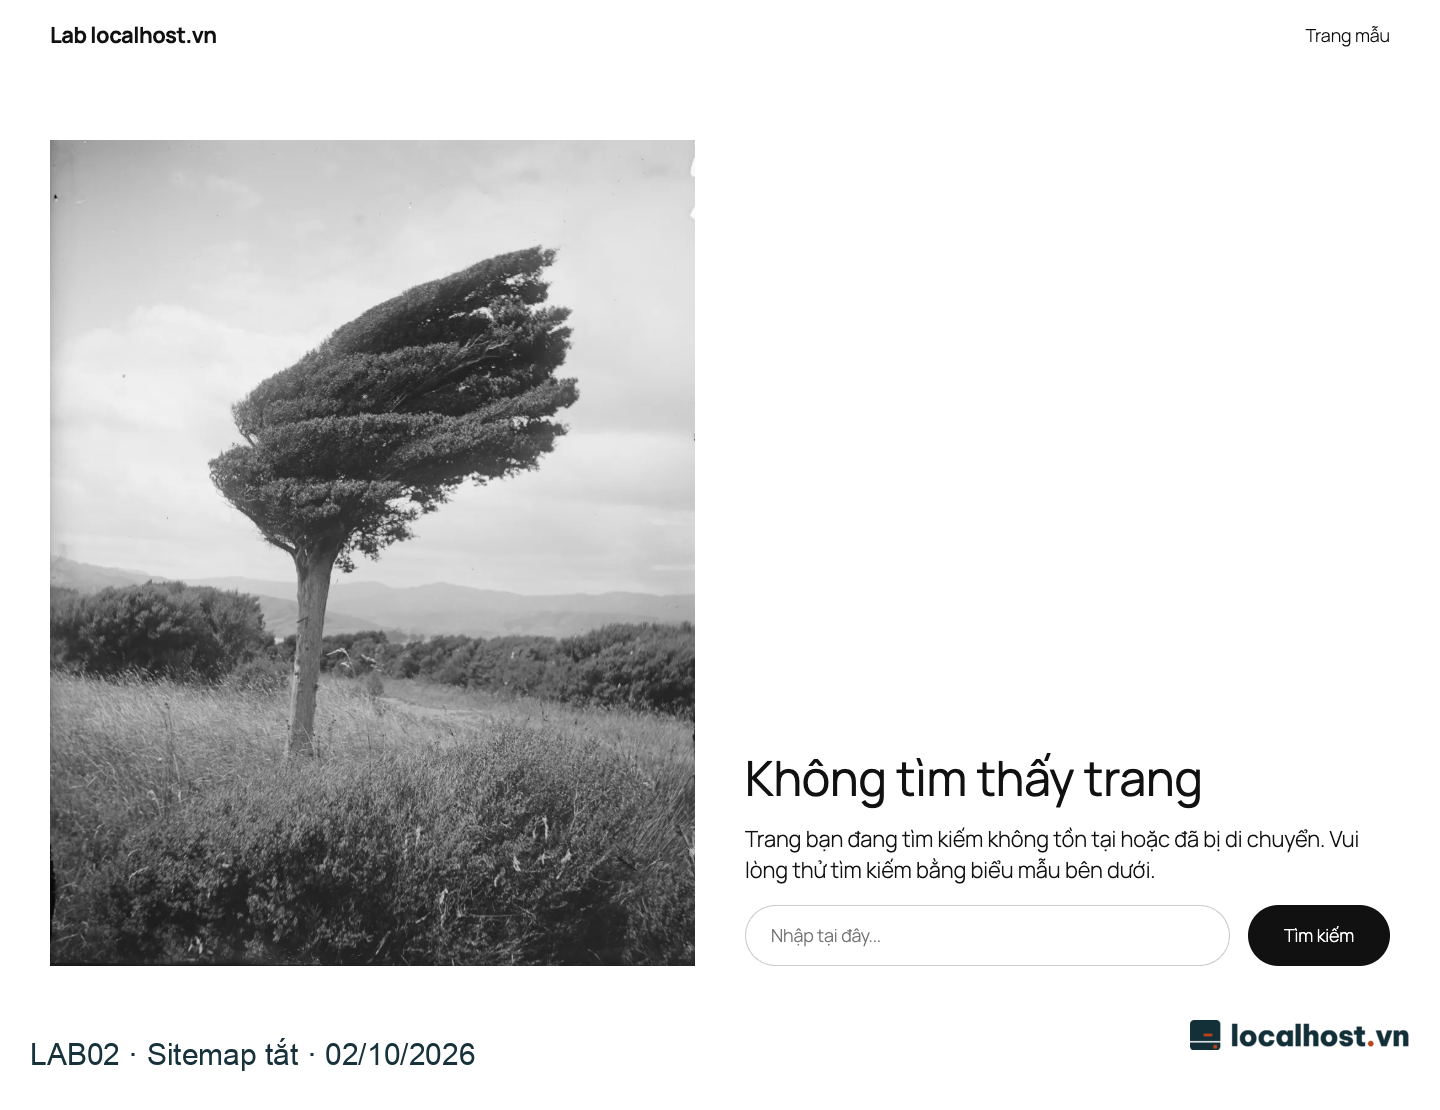
Ngược lại, khi bạn kiểm tra trên một máy chủ lab đang bật chế độ chặn lập chỉ mục (noindex) mà thấy đường dẫn /wp-sitemap.xml trả về lỗi 404 Not Found, đừng vội tưởng web bị hỏng! Đó là hành vi hoàn toàn thông minh và đúng thiết kế của WordPress Core: khi bạn tích chọn ô ngăn công cụ tìm kiếm ở Bước 1, WordPress sẽ tự động vô hiệu hóa luôn tính năng sinh XML Sitemap để tránh việc vừa xua đuổi bot vừa vẽ bản đồ mời bot vào nhà. Trong môi trường lab, hãy giữ nguyên trạng thái khóa an toàn đó chứ đừng dại dột mở khóa index công khai chỉ để nhìn thấy file XML.
Ảnh chụp giao diện thực tế ngày 02/10/2026 khi truy cập đường dẫn /wp-sitemap.xml trên máy chủ LAB02 đang khóa chỉ mục. Phản hồi HTTP được kiểm chứng độc lập trả về mã 404 với kiểu nội dung text/html (hiển thị trang báo lỗi “Không tìm thấy trang” của giao diện mặc định). Đây là minh chứng cho thấy core sitemap đã tự động tắt theo thiết lập bảo vệ của lab.
Một nguyên tắc vàng khi vận hành là chỉ giao quyền sinh XML Sitemap cho duy nhất một công cụ trên website, tránh cảnh vừa bật plugin tạo sitemap riêng vừa cài thêm tiện ích khác đẻ ra hai ba bộ sơ đồ đá nhau chan chát. Đối với các website quy mô vừa và nhỏ, việc rà soát kỹ một vài URL đại diện cho trang chủ, bài viết chi tiết và trang giới thiệu đã giúp bạn phát hiện được 95% lỗi cấu hình hệ thống; việc nộp chồng chéo nhiều file sitemap trùng lặp lên Google hoàn toàn không giúp website của bạn được ưu ái hơn chút nào.
Cũng cần hiểu đúng bản chất: XML Sitemap đóng vai trò như “tấm bản đồ du lịch” giúp Googlebot khám phá các đường dẫn trên web của bạn nhanh và đầy đủ hơn, nhưng quyền quyết định có thu thập dữ liệu (crawl) và đưa trang đó vào chỉ mục tìm kiếm (index) hay không vẫn nằm hoàn toàn ở thuật toán đánh giá chất lượng của Google. Đặc biệt, thẻ thời gian chỉnh sửa cuối (<lastmod>) trong sitemap phải phản ánh đúng thời điểm bài viết có thay đổi nội dung thực sự — đừng dùng chiêu trò tự động cập nhật lại ngày giờ mới tinh cho toàn bộ bài cũ mỗi ngày để đánh lừa bot, vì Google đủ thông minh để nhận ra và phớt lờ luôn nhãn thời gian của bạn. Xem hướng dẫn chính thống tại Google Search Central: Xây dựng và gửi Sitemap.
Bước 3: Đọc hiểu robots.txt và phân biệt rạch ròi với chỉ thị noindex
Hãy mở trình duyệt truy cập vào địa chỉ https://TEN-MIEN-CUA-BAN/robots.txt để kiểm tra nội dung văn bản trả về. Hãy soi thật kỹ xem có dòng lệnh Disallow nào đang vô tình chặn đứng toàn bộ website, chặn đường dẫn tới file sitemap hoặc chặn các thư mục chứa file CSS/JS khiến Googlebot không thể dựng hình (render) giao diện trang web hay không. Sai lầm kinh điển nhất sau những đợt chuyển web từ máy chủ nháp (staging) lên máy chủ thật (production) là bê nguyên xi dòng lệnh Disallow: / đi theo, khóa trái cửa trước mũi Googlebot!
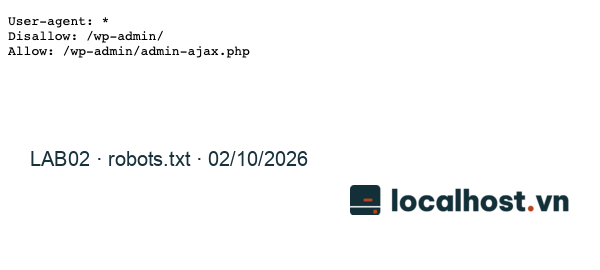
Ảnh chụp trực tiếp màn hình văn bản /robots.txt trên trình duyệt Chromium lúc 07:57 ngày 02/10/2026 của máy chủ LAB02, giữ nguyên vẹn kích thước chữ và pixel gốc. Phản hồi mạng trả về mã HTTP 200 cùng kiểu dữ liệu chuẩn text/plain.
Ở đây có một nghịch lý kỹ thuật cực kỳ thú vị mà ngay cả nhiều người làm SEO lâu năm cũng hay nhầm lẫn: sự khác biệt giữa chặn thu thập dữ liệu (Disallow trong robots.txt) và chặn lập chỉ mục (thẻ noindex). Tập tin robots.txt chỉ bảo với con bọ tìm kiếm rằng “Đừng bò vào đường dẫn này để đọc nội dung”; nhưng nếu có một trang web khác trên mạng đặt liên kết trỏ tới URL đó của bạn, Google vẫn có thể đưa cái URL đó lên kết quả tìm kiếm (dù không có mô tả nội dung) mà không cần đọc trang! Muốn ra lệnh dứt khoát cho Google “Tuyệt đối không được đưa trang này lên kết quả tìm kiếm”, bạn phải dùng thẻ meta noindex trong phần <head> của HTML hoặc HTTP header X-Robots-Tag: noindex. Và trớ trêu thay: để Googlebot nhìn thấy được chữ noindex nằm bên trong trang, bạn không được chặn nó bằng Disallow trong robots.txt! Nếu bạn vừa gắn thẻ noindex bên trong phòng, vừa khóa trái cửa ngoài cổng bằng robots.txt, Googlebot sẽ đứng ngoài cổng quay về và không bao giờ đọc được lệnh xóa trang của bạn. Đọc kỹ hai tài liệu nền tảng này của Google để nắm chắc bản chất: Giới thiệu về robots.txt và Chặn lập chỉ mục tìm kiếm bằng noindex.
Vì vậy, khi kiểm tra một trang web, bạn hãy bấm View Page Source (Ctrl+U) để tìm thẻ <meta name="robots" ...> đồng thời dùng lệnh curl -I để soi dòng header X-Robots-Tag từ phía người dùng chưa đăng nhập. Hãy luôn tin vào dữ liệu phản hồi thực tế trên mạng chứ đừng chỉ nhìn vào nút gạt trong trang quản trị — bởi rất nhiều khi bạn đã bỏ chọn noindex trong WordPress rồi nhưng bộ nhớ đệm (cache) chưa xóa vẫn tiếp tục phát thẻ noindex cũ cho Googlebot suốt nhiều ngày liền!
Sơ đồ trước gửi sitemap: Đúng domain canonical; Không có URL staging; Trang trả status phù hợp; Không vô tình noindex
Sơ đồ 4 bước rà soát chất lượng trước khi nộp Sitemap do localhost.vn biên soạn để minh họa quy trình, không phải ảnh chụp từ môi trường lab.
Bước 4: Lựa chọn đúng loại tài sản (Property) và xác minh Google Search Console
Ảnh chụp trang tài liệu hướng dẫn chính thức của Google ngày 02/10/2026 về các phương thức xác minh quyền sở hữu trang web, giữ nguyên pixel gốc. Xem tài liệu gốc tại đây.
Khi thêm một website mới vào Google Search Console, màn hình sẽ đưa ra cho bạn hai ngả rẽ: Domain property (Tài sản tên miền) và URL-prefix property (Tài sản tiền tố URL). Sự khác biệt rất rõ ràng: Domain property bắt buộc phải xác minh qua bản ghi DNS nhưng đổi lại nó gom trọn mọi biến thể giao thức (cả http lẫn https) và mọi tên miền phụ (www, m, subdomain…) vào chung một bảng theo dõi toàn diện. Trong khi đó, URL-prefix property chỉ theo dõi đúng nhánh địa chỉ bắt đầu bằng chuỗi ký tự bạn nhập vào (ví dụ chỉ riêng https://localhost.vn/) và cho phép xác minh linh hoạt bằng file HTML tải lên web, thẻ meta hoặc Google Analytics. Hãy chọn loại tài sản đúng với phạm vi thẩm quyền mà bạn được giao quản lý.
Chẳng hạn, nếu bạn chỉ được phân công phụ trách một chuyên trang nằm trên tên miền phụ (subdomain) hoặc một thư mục con riêng biệt, hãy chọn URL-prefix đúng phạm vi đó thay vì đòi quyền xác minh cấp cao trên toàn bộ tên miền gốc của tập đoàn. Về nguyên tắc bảo mật tài khoản, chủ sở hữu doanh nghiệp nên đứng tên xác minh chính rồi dùng tính năng phân quyền người dùng (Users and permissions) trong GSC để cấp quyền xem hoặc quyền đầy đủ cho kỹ thuật viên, tuyệt đối tránh việc truyền tay nhau mật khẩu tài khoản Google dùng chung.
Khi thực hiện xác minh bằng bản ghi DNS TXT, bạn chỉ cần sao chép chính xác chuỗi mã token mà Google Search Console cấp riêng cho tài sản đó và thêm một bản ghi loại TXT mới vào bảng điều khiển DNS đang có hiệu lực của tên miền (tuyệt đối không sửa hay xóa các bản ghi A, MX hoặc các dòng TXT đang phục vụ SPF/DKIM). Sau khi lưu bản ghi và chờ vài phút để hệ thống DNS phân giải xong, bạn bấm nút Verify. Một lưu ý sống còn: sau khi đã xác minh thành công, bạn phải giữ nguyên bản ghi TXT đó trong DNS lâu dài, vì Google sẽ định kỳ kiểm tra lại; nếu bạn dọn dẹp tay chân mà xóa mất dòng TXT này, quyền truy cập Search Console sẽ bị thu hồi sau một thời gian ngắn! Xem hướng dẫn chi tiết tại Google Search Console Help: Xác minh quyền sở hữu trang web.
Bước 5: Nộp Sitemap lên Search Console và soi chiếu bằng công cụ URL Inspection
Sau khi đã bước vào bên trong giao diện quản trị của đúng Property trên Google Search Console, bạn mở mục Sitemaps (Sơ đồ trang web) ở thanh menu bên trái, điền đường dẫn file sitemap chính thức đang hoạt động (ví dụ wp-sitemap.xml) vào ô và bấm Submit (Gửi). Hãy ghi chép lại mốc thời gian nộp, đường dẫn đã gửi cùng con số URL được khám phá mà công cụ hiển thị. Hãy nhớ rằng dòng thông báo nộp sitemap thành công mới chỉ xác nhận Google đã ghi vào sổ lịch hẹn sẽ tới đọc bản đồ của bạn, hoàn toàn chưa có nghĩa là toàn bộ bài viết bên trong đã được lập chỉ mục ngay tức khắc.
Ảnh chụp trang tài liệu trợ giúp chính thức của Google ngày 02/10/2026 giải thích về báo cáo Sitemaps (nút bấm trong ảnh là liên kết mở công cụ trên trang tài liệu của Google). Xem chi tiết tại Google Help: Sitemaps report.
Khi nhìn vào cột Trạng thái (Status) trong bảng danh sách Sitemaps, bạn cần hiểu đúng ý nghĩa của ba nhãn phổ biến sau để có hướng xử lý chuẩn xác:
Nhãn trạng thái trên GSC
Ý nghĩa thực chất và hành động cần làm
Success (Thành công)
Google đã tải và đọc cấu trúc file XML Sitemap trơn tru không gặp lỗi cú pháp; lưu ý điều này chưa đồng nghĩa với việc các trang con bên trong đều đã được lập chỉ mục (index)
Couldn’t fetch (Không thể tìm nạp)
Google chưa lấy được hoặc chưa xử lý xong file sitemap; cần kiểm tra lại đường dẫn đã nộp, thử mở bằng trình duyệt ẩn danh, kiểm tra tường lửa/robots.txt và dùng Live Test để chẩn đoán
Has errors (Có lỗi)
Tải được file nhưng phát hiện lỗi bên trong (như sai định dạng XML, lẫn URL bị chặn hoặc chuyển hướng); hãy bấm trực tiếp vào dòng đó để đọc chi tiết từng lỗi và khắc phục
Lưu ý rằng bảng báo cáo Sitemaps này chỉ liệt kê những sơ đồ trang web mà bạn chủ động nhập vào qua giao diện hoặc gửi qua API trong đúng Property đang mở. Những sitemap mà Google tự tình cờ tìm thấy thông qua dòng khai báo trong robots.txt có thể sẽ không hiện thành dòng riêng ở bảng này. Nếu mở vào mà thấy trống trơn, hãy kiểm tra xem bạn có đang chọn nhầm Property (ví dụ nhầm giữa bản http và https) hay không trước khi hốt hoảng. Xem thêm tại Tài liệu Google: Phạm vi và ý nghĩa trạng thái báo cáo Sitemaps (đối chiếu ngày 02/10/2026).
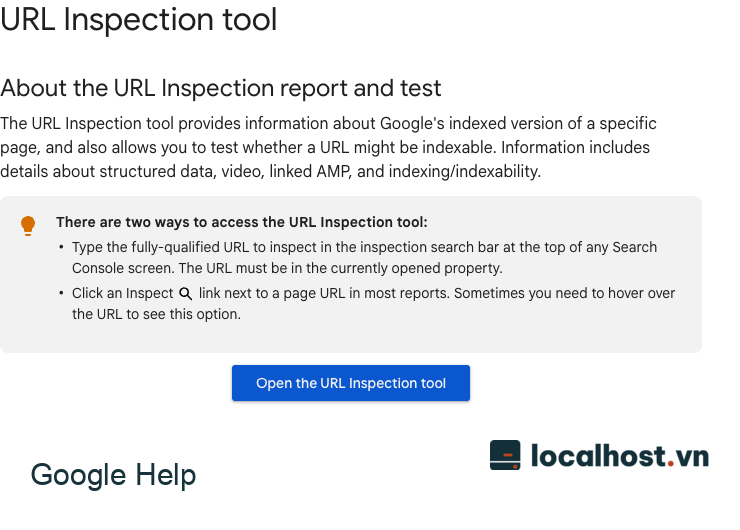
Tiếp theo, hãy chọn ra một vài đường dẫn quan trọng nhất (như trang chủ và một bài viết trụ cột), dán vào thanh tìm kiếm trên cùng của GSC để chạy công cụ URL Inspection (Kiểm tra URL). Công cụ này bao gồm hai chế độ nhìn rất khác nhau mà bạn phải phân biệt rõ: màn hình đầu tiên hiển thị dữ liệu đang lưu trong chỉ mục của Google (có thể là dữ liệu từ lần Googlebot ghé thăm vài ngày trước), còn khi bạn bấm nút Test Live URL (Kiểm tra URL trực tiếp) ở góc phải, Google sẽ cử bot chạy tới đọc trang web của bạn ngay tại giây phút hiện tại. Vì vậy, ngay sau khi bạn vừa gỡ thẻ noindex trên web, kết quả Live Test sẽ báo xanh ngay lập tức rằng trang đã cho phép lập chỉ mục, trong khi trạng thái lưu trữ trong bộ nhớ chỉ mục vẫn cần thời gian để cập nhật theo.
Ảnh chụp trang tài liệu chính thức của Google ngày 02/10/2026 hướng dẫn phân biệt giữa trạng thái trong chỉ mục và kết quả kiểm tra trực tiếp (Live Test). Xem tại Tài liệu chính thức về URL Inspection Tool.
Hãy luôn ghi chép tách biệt kết quả ở màn hình chỉ mục và kết quả Live Test. Cũng cần nhớ rằng Live Test chỉ kiểm tra khả năng truy cập kỹ thuật tức thời tại URL đó chứ không xét đến toàn bộ các yếu tố tổng thể (như việc URL đó có nằm trong sitemap hay không, hoặc Google có chọn một trang trùng lặp khác làm Canonical hay không). Sau khi Live Test chạy xong, bạn hãy bấm vào nút View tested page (Xem trang đã kiểm tra) để kiểm tra mã HTML, HTTP response headers và ảnh chụp màn hình mà Googlebot nhìn thấy. Tham khảo chi tiết tại Giới hạn kỹ thuật của Live Test trên Google Search Console.
Nếu trang viết thực sự đã hoàn thiện chỉn chu và giao diện hiển thị nút Request Indexing (Yêu cầu lập chỉ mục), bạn có thể bấm một lần để ưu tiên đưa URL đó vào hàng đợi thu thập dữ liệu. Tuyệt đối đừng ngồi bấm đi bấm lại nút này hàng chục lần cho cùng một bài viết — làm vậy không giúp trang lên Google nhanh hơn mà chỉ khiến bạn sớm bị khóa hạn mức yêu cầu trong ngày. Đối với website có hàng trăm bài viết, chìa khóa bền vững nhất luôn là cấu trúc liên kết nội bộ (internal links) mạch lạc kết hợp với một bản XML Sitemap sạch sẽ.
Bước 6: Theo dõi nhịp đập của Website qua các báo cáo theo thời gian
Sau ngày ra mắt, công việc của người quản trị là thiết lập thói quen kiểm tra định kỳ hàng tuần hai mục: báo cáo Sitemaps và báo cáo Page indexing (Lập chỉ mục trang). Khi đọc số liệu trên Google Search Console, hãy luôn nhớ rằng dữ liệu báo cáo luôn có độ trễ tự nhiên (data latency) từ một vài ngày so với thời gian thực. Một website mới tinh vừa mở cửa ngày đầu tiên mà biểu đồ lượt hiển thị (Impressions) vẫn nằm im ở số 0 là chuyện hết sức bình thường của quá trình thu thập và xếp hạng, đừng vội hoang mang tưởng website bị Google phạt (penalty)!
Đặc biệt, khi mở bảng thống kê những trang “Chưa được lập chỉ mục” (Not indexed), bạn hãy đọc kỹ từng nhóm nguyên nhân thay vì hoảng hốt tìm cách ép tất cả phải xanh: có những trang bị loại trừ hoàn toàn đúng với thiết kế tốt của bạn! Ví dụ: đường dẫn HTTP cũ báo Page with redirect (vì đã chuyển hướng 301 sang HTTPS), trang giỏ hàng hay trang quản trị báo Excluded by ‘noindex’ tag, hoặc các đường dẫn có gắn tham số theo dõi quảng cáo báo Alternate page with proper canonical tag. Hãy chỉ can thiệp sửa lỗi khi một bài viết chính thức cần lên Top mà lại nằm nhầm trong danh sách bị chặn hoặc báo lỗi máy chủ 5xx / 404.
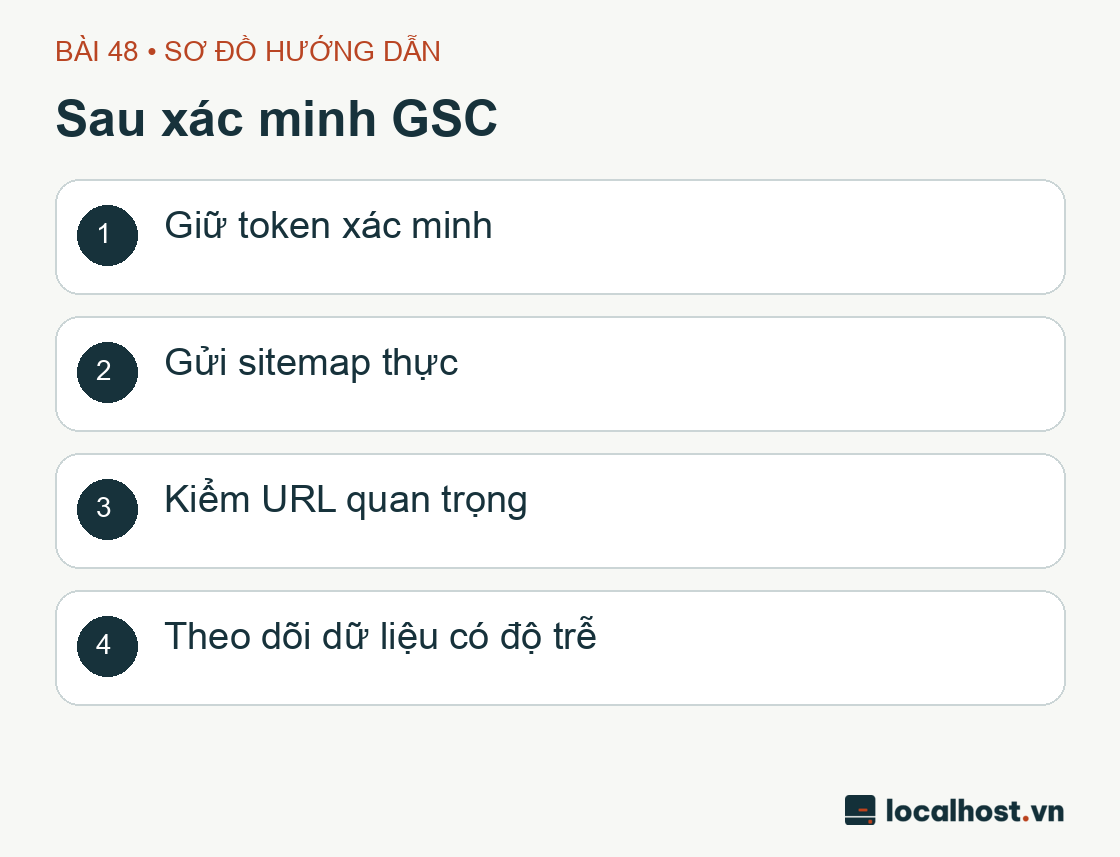
Sơ đồ sau xác minh gsc: Giữ token xác minh; Gửi sitemap thực; Kiểm URL quan trọng; Theo dõi dữ liệu có độ trễ
Sơ đồ quy trình vận hành và theo dõi Google Search Console dài hạn do localhost.vn biên soạn để minh họa quy trình, không phải ảnh chụp từ môi trường lab.
Xử lý sự cố, Rollback và Giải đáp thắc mắc thường gặp (FAQ)
Nếu chẳng may phát hiện mình vừa sơ ý mở khóa cho phép lập chỉ mục nhầm trên một máy chủ thử nghiệm (staging), hãy lập tức bật lại chỉ thị noindex (qua cả cài đặt WordPress lẫn HTTP header X-Robots-Tag trên NGINX) hoặc đặt mật khẩu khóa truy cập HTTP Basic Auth ngay. Chỉ sử dụng công cụ yêu cầu xóa URL tạm thời (Removals tool) trong Search Console khi thực sự cần ẩn gấp thông tin bị lộ và nhớ chọn đúng property của máy chủ nháp. Còn nếu trong lúc dọn dẹp bảng DNS bạn lỡ tay xóa nhầm bản ghi TXT xác minh quyền sở hữu GSC, bạn chỉ cần mở lại phần cài đặt xác minh trong Search Console, lấy lại đúng chuỗi token của tài sản đó và tạo lại bản ghi TXT tương ứng là xong.
Câu hỏi thường gặp 1: Báo cáo Sitemap đã hiện chữ “Success” màu xanh lá cây, vậy là công việc SEO cho website đã hoàn thành mỹ mãn rồi đúng không?
Còn xa lắm bạn ơi! Chữ Success ở mục Sitemap mới chỉ xác nhận một việc duy nhất: Googlebot đã đọc hiểu được tờ danh sách đường dẫn của bạn mà không gặp lỗi cú pháp XML. Còn việc từng bài viết trong danh sách đó có đủ chất lượng, chiều sâu, tốc độ tải trang và trải nghiệm người dùng để được Google đưa vào chỉ mục và xếp hạng cao hay không lại là một cuộc đua đường dài hoàn toàn khác.
Câu hỏi thường gặp 2: Tôi có một thư mục chứa tài liệu nội bộ trên web, tôi thêm dòng Disallow: /tai-lieu-mat/ vào file robots.txt để giấu đi có an toàn không?
Tuyệt đối Không! Làm vậy chẳng khác nào dán tờ giấy trước cửa nhà kho ghi chữ “Ở phần đường dẫn /tai-lieu-mat/ có giấu đồ quý, xin đừng vào xem”! Vì tập tin robots.txt nằm công khai cho cả thế giới đọc được, kẻ xấu thường mở chính file robots.txt đầu tiên để xem chủ web đang muốn giấu những đường dẫn nhạy cảm nào rồi tìm cách truy cập thẳng vào đó. Mọi tài liệu bí mật bắt buộc phải được bảo vệ bằng cơ chế kiểm soát truy cập và xác thực đăng nhập ở tầng máy chủ.
Hồ sơ bằng chứng nghiệm thu cần lưu giữ: Khi bàn giao hạng mục này, hãy lưu lại kết quả phản hồi của đường dẫn XML Sitemap, nội dung file robots.txt và trạng thái thẻ noindex trên trang thật, màn hình xác nhận quyền sở hữu Property đúng phạm vi và trạng thái báo cáo thực tế trong Google Search Console.
Báo cáo kết quả rà soát robots.txt và Sitemap trên máy chủ LAB-CF-02 (Ngày 01/10/2026)
Phiên rà soát trạng thái khóa chỉ mục diễn ra lúc 00:02–00:03 (UTC+7) ngày 01/10/2026 trên nền tảng WordPress 7.1.2 của máy chủ thử nghiệm LAB-CF-02. Để bảo vệ môi trường lab không bị lọt lên bộ máy tìm kiếm, hệ thống giữ nguyên cấu hình blog_public = 0; kết quả truy vấn hàm lõi cho giá trị sitemaps_enabled = false và không có plugin nào đang kích hoạt tại thời điểm kiểm tra:
Hạng mục kiểm tra trên LAB-CF-02
Kết quả quan sát thực tế
Đường dẫn /robots.txt
Trả về mã 200 OK, kiểu nội dung text/plain; bên trong hoàn toàn không xuất dòng khai báo Sitemap:
Đường dẫn /wp-sitemap.xml
Trả về mã 404 Not Found, nội dung dạng trang HTML báo lỗi; không sinh ra các thẻ XML sitemapindex hay urlset
Trang chủ và bài viết thử nghiệm
Cả thẻ meta robots trong HTML lẫn HTTP header X-Robots-Tag đều phát ra chỉ thị noindex, nofollow
Truy cập bài viết thử nghiệm qua HTTPS
Trả về mã 200 OK, thẻ canonical trỏ chuẩn về địa chỉ HTTPS /bai-thu/; văn bản tiếng Việt hiển thị nguyên vẹn
Nội dung văn bản thực tế mà đường dẫn /robots.txt của máy chủ lab trả về trong phiên kiểm tra gồm đúng 3 dòng tiêu chuẩn sau:
Nhìn vào 3 dòng trên, nhiều bạn mới vào nghề sẽ thắc mắc: “Ơ kìa, sao đã tích chọn ô chặn Google trong mục Reading mà file robots.txt lại không có dòng Disallow: / chặn toàn bộ trang web?”. Đây chính là kiến thức cốt lõi đã giải thích ở Bước 3: kể từ phiên bản WordPress 5.3 trở đi, đội ngũ phát triển WordPress đã bỏ cơ chế chèn Disallow: / vào robots.txt khi người dùng bật chế độ Discourage search engines, mà chuyển sang xuất thẻ meta noindex, nofollow trực tiếp trên từng trang! Nhờ vậy, Googlebot vẫn được phép vào đọc trang để nhìn thấy tận mắt lệnh noindex và loại bỏ trang khỏi kết quả tìm kiếm một cách dứt khoát. Bạn có thể xem trực tiếp mã nguồn hàm xử lý này tại WordPress Code Reference: do_robots().
Đồng thời, việc đường dẫn /wp-sitemap.xml trả về mã 404 hoàn toàn ăn khớp 100% với thiết kế của hàm lõi WordPress khi biến blog_public mang giá trị 0 (bạn có thể đối chiếu logic kiểm tra tại WP_Sitemaps::sitemaps_enabled()). Tất nhiên, trạng thái 404 có chủ đích trên máy chủ lab đang khóa noindex này chỉ xác nhận cơ chế tự tắt của lab hoạt động đúng, chứ chưa phải là bài kiểm tra chứng minh file XML Sitemap trên môi trường mở hoạt động ra sao — mảnh ghép đó sẽ được thực nghiệm ngay trên bản clone nội bộ ở mục kế tiếp.
Trong suốt phiên rà soát ngày 01/10 trên máy chủ lab, chúng tôi giữ nguyên trạng thái khóa chỉ mục, không thay đổi DNS, không tạo Property hay nộp URL của lab lên Google Search Console.
Đối chiếu giao diện Quản trị và phản hồi phía Khách truy cập (Ngày 02/10/2026)
Trong khung giờ 07:57:16–07:57:19 sáng ngày 02/10/2026 (UTC+7), chúng tôi sử dụng trình duyệt Chrome phiên bản 154.0.8037.93 trong một phiên làm việc tách biệt để mở trực tiếp máy chủ LAB02. Tại màn hình quản trị Settings → Reading, trang trả về mã 200 và ô tùy chọn ngăn công cụ tìm kiếm lập chỉ mục đang được tích chọn rõ ràng. Ngay sau khi ghi nhận ảnh chụp màn hình, tài khoản quản trị lab thực hiện đăng xuất hoàn toàn; việc truy cập lại vào /wp-admin/ lập tức bị chuyển hướng về màn hình yêu cầu đăng nhập và toàn bộ cookie phiên quản trị đã được xóa sạch. Ba bức ảnh chụp giao diện Reading, trang 404 Sitemap và màn hình robots.txt ở nửa đầu bài viết chính là kết quả thu được từ phiên kiểm tra trực quan ngày 02/10 này.
Ở góc độ khách truy cập ẩn danh sau khi đã đăng xuất, đường dẫn /robots.txt vẫn trả về mã 200 với đúng 3 dòng cấu hình chuẩn; đường dẫn /wp-sitemap.xml trả về mã 404 kèm giao diện HTML “Không tìm thấy trang”. Trong khi đó, bài viết thử nghiệm tại /bai-thu/ trả về mã 200 mượt mà, hiển thị đúng nội dung nhận diện của LAB-CF-02, thẻ canonical trỏ chuẩn về HTTPS và cả hai lớp khóa — thẻ meta robots trong cây DOM lẫn HTTP header X-Robots-Tag — đều phát ra giá trị noindex, nofollow không sai một chữ.
Bài học rút ra từ phép đối chiếu: Màn hình cài đặt trong Dashboard thể hiện ý định cấu hình của người quản trị, tập tin robots.txt thể hiện quy tắc dẫn đường cho crawler, còn HTTP response headers và mã nguồn HTML trả về cho khách vãng lai mới là mệnh lệnh thực thi cuối cùng mà Googlebot nhận được. Phiên kiểm tra lúc 07:57 sáng ngày 02/10 hoàn toàn chỉ đọc (read-only), không lưu đè cấu hình và đóng trình duyệt ngay sau khi hoàn tất.
Thực nghiệm kích hoạt và mổ xẻ XML Sitemap thật trên bản Clone nội bộ lúc 09:09
Làm thế nào để kiểm tra tận mắt cấu trúc XML Sitemap do WordPress sinh ra mà vẫn đảm bảo nguyên tắc kỷ luật thép là không mở khóa noindex trên máy chủ lab công khai? Vào lúc 09:09:51–09:09:56 sáng ngày 02/10/2026 (giờ Việt Nam), chúng tôi thực hiện bài kiểm tra trên một bản clone cô lập của LAB-CF-02 chỉ lắng nghe tại địa chỉ nội bộ 127.0.0.1:8081, truy cập qua đường hầm SSH. Lưu ý tên miền đuôi .test và giao thức HTTP hiển thị trong hai bức ảnh dưới đây là địa chỉ loopback nội bộ của bản clone phục vụ kiểm tra cấu trúc XML, tuyệt đối không phải là URL sản phẩm để đem nộp lên Google (trên website thật, mọi URL trong sitemap bắt buộc phải mang giao thức HTTPS và tên miền chính thức).
Trên bản clone này, chúng tôi vẫn giữ nguyên blog_public = 0 và ép header NGINX X-Robots-Tag: noindex, nofollow trên mọi phản hồi. Để bật riêng bộ tạo XML Sitemap phục vụ quan sát, chúng tôi gắn một bộ lọc (filter) tạm thời vào hook wp_sitemaps_enabled chỉ trả về giá trị true khi đúng tên Host của bản clone, và tháo gỡ ngay lập tức sau 5 giây chụp ảnh. Đây là kỹ thuật móc filter thuần túy phục vụ diễn tập trong phòng lab (trên website sản phẩm thực tế khi bạn bỏ tích ô chặn index ở mục Reading thì Sitemap sẽ tự động bật mà không cần viết dòng code filter nào cả). Bạn có thể tham khảo cơ chế hoạt động của hai lớp này tại WP_Sitemaps::sitemaps_enabled() và WP_Sitemaps::render_sitemaps() (đối chiếu ngày 02/10/2026).
Quy trình đọc và kiểm tra 3 tầng của một bản XML Sitemap chuẩn:
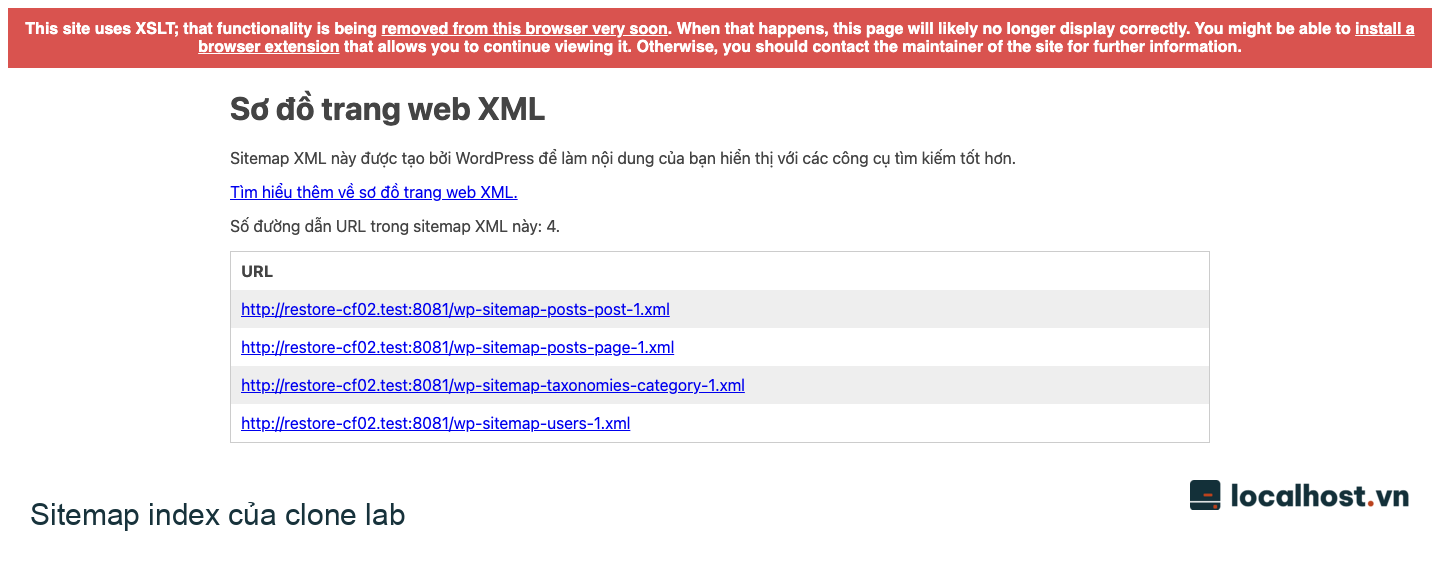
Tầng 1 — Mở sơ đồ tổng (/wp-sitemap.xml): Kiểm tra xem đây có đúng là một Sitemap Index (danh mục chứa các sơ đồ con) hay không. Chú ý con số 4 hiển thị trên màn hình là số lượng 4 sơ đồ con được phân loại theo nhóm nội dung, chứ không phải tổng số bài viết trên web.
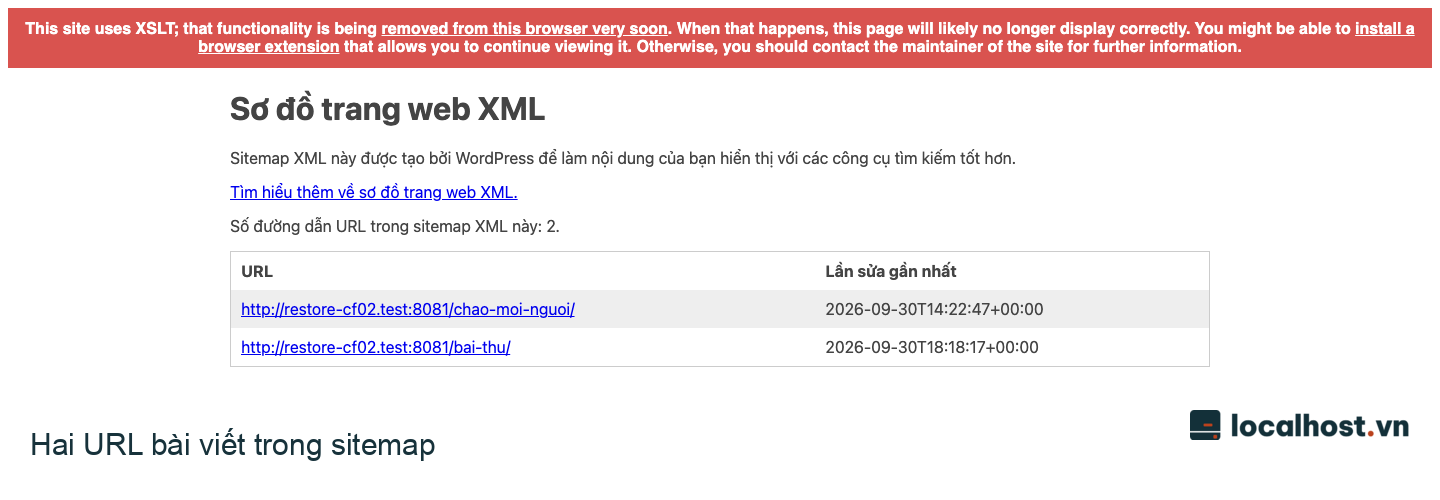
Tầng 2 — Mở sơ đồ con của nhóm Bài viết (wp-sitemap-posts-post-1.xml): Kiểm tra danh sách các đường dẫn bài viết cụ thể cùng cột thời gian chỉnh sửa cuối (Last Modified). Trên bản clone này, danh sách liệt kê chính xác 2 đường dẫn bài viết; chuỗi thời gian có hậu tố +00:00 biểu thị múi giờ chuẩn quốc tế UTC (chênh 7 tiếng so với giờ Việt Nam).
Tầng 3 — Mở trực tiếp từng URL bài viết nằm trong danh sách: Xác nhận từng đường dẫn đều mở ra nội dung thật với mã phản hồi HTTP 200. Hãy nhớ: việc một đường dẫn có mặt trong file XML không tự động chứng minh đường dẫn đó không bị lỗi 404 hay đã được phép lập chỉ mục.
Ảnh chụp giao diện Sitemap Index thực tế trên trình duyệt Chromium lúc 09:09 sáng ngày 02/10/2026, liệt kê rõ 4 sơ đồ con gồm: bài viết (posts), trang tĩnh (pages), chuyên mục (categories) và tác giả (users). Bấm vào ảnh để xem rõ từng đường dẫn.
Ảnh chụp sơ đồ con của nhóm bài viết (wp-sitemap-posts-post-1.xml) do WordPress sinh tự động, hiển thị 2 đường dẫn bài viết cùng mốc thời gian chuẩn UTC. Cả hai bài viết đều trả về mã HTTP 200 khi truy cập và vẫn nằm an toàn dưới lớp bảo vệ noindex của môi trường thử nghiệm.
Một chi tiết kỹ thuật thú vị trên trình duyệt Chrome 154: phía trên đầu trang XML Sitemap xuất hiện một dải thông báo màu đỏ cảnh báo về việc ngưng hỗ trợ định dạng trình bày giao diện bằng XSLT. Tuy nhiên, hãy hoàn toàn yên tâm: XSLT chỉ là lớp “áo trang điểm” giúp con người khi mở file XML trên trình duyệt nhìn thấy bảng biểu đẹp mắt, còn các con bọ tìm kiếm như Googlebot chỉ đọc dữ liệu XML thô! Trong phiên kiểm tra này, dữ liệu XML trả về mã 200 OK chuẩn mực với kiểu application/xml; charset=UTF-8, bộ phân tích cú pháp XML đọc trơn tru các thẻ sitemapindex và urlset, đồng thời mã băm SHA-256 khớp tuyệt đối. Vì vậy, dải cảnh báo giao diện XSLT trên Chrome hoàn toàn không phải là lỗi hỏng Sitemap.
Hạng mục kiểm tra trên Clone
Kết quả ghi nhận lúc 09:09 ngày 02/10/2026
Sơ đồ tổng /wp-sitemap.xml
Trả về HTTP 200, cấu trúc XML hợp lệ, liệt kê đủ 4 sơ đồ con
Sơ đồ con nhóm Bài viết
Trả về HTTP 200, chứa đúng 2 URL thuộc tên miền nội bộ của bản clone
Truy cập thực tế 2 URL bài viết trong danh sách
Cả hai đường dẫn đều mở thành công với mã HTTP 200
Trạng thái khóa bảo vệ chỉ mục
Giữ nguyên blog_public = 0; header X-Robots-Tag: noindex, nofollow hiện diện đầy đủ trên cả file XML lẫn trang bài viết
Sau khi tháo gỡ filter tạm thời (09:09:56)
Đường dẫn Sitemap quay về trạng thái 404 mặc định, bài viết thử nghiệm vẫn trả về 200; toàn bộ cấu hình và dữ liệu nguyên vẹn
Để có được bức ảnh chụp lúc 09:09 trên, chúng tôi cũng ghi nhận minh bạch hai lần căn chỉnh công cụ trước đó: lúc 09:06, việc đặt quyền thư mục chứa file filter tạm quá chặt khiến PHP chưa đọc được code nên Sitemap vẫn báo 404; lúc 09:08, XML đã sinh ra thành công nhưng công cụ chụp ảnh tự động chờ điều kiện networkidle bị quá thời gian (timeout). Việc ghi chép rõ ràng từng bước giúp phân biệt rạch ròi giữa lỗi tham số của công cụ kiểm thử với trạng thái vận hành thực tế của máy chủ web.
Đúng 09:09:56, toàn bộ file filter tạm đã được xóa bỏ, đóng trình duyệt cùng đường hầm SSH và đưa bản clone về đúng trạng thái baseline ban đầu.
Thực chiến trên Production: Khai báo Search Console cho localhost.vn chiều 02/10/2026
Bước sang buổi chiều ngày 02/10/2026 (giờ Việt Nam), chúng tôi thực hiện quy trình chuẩn mực trên hệ thống sản phẩm thật là tên miền localhost.vn. Quyền sở hữu tài sản cấp độ tên miền (Domain property localhost.vn) đã được Google xác nhận thành công thông qua bản ghi DNS TXT. Như đã dặn dò ở Bước 4, bản ghi TXT xác minh này được giữ cố định lâu dài trong cấu hình DNS của tên miền và tất nhiên chuỗi mã token cụ thể được bảo mật không công khai trên mặt báo.
Đường dẫn sơ đồ trang web chính thức của hệ thống sản phẩm là https://localhost.vn/wp-sitemap.xml. Chúng tôi đã thực hiện nộp đường dẫn này trong mục Sitemaps và theo dõi sát sao diễn biến xử lý của Google qua 3 mốc thời gian trong buổi chiều cùng ngày:
Hạng mục và Mốc thời gian
Kết quả quan sát trên GSC
Ý nghĩa kỹ thuật rút ra
1. Xác minh Domain Property
Google xác nhận quyền sở hữu thành công qua bản ghi DNS TXT
Hoàn tất quyền quản trị toàn diện tên miền trên GSC; giữ cố định bản ghi TXT
2. Gửi đường dẫn Sitemap
Hệ thống hiển thị thông báo đã tiếp nhận yêu cầu nộp sitemap
Xác nhận GSC đã đưa đường dẫn vào hàng đợi xử lý
3. Chạy Live Test cho URL Sitemap (14:26:58)
Crawl allowed: Có; Page fetch: Thành công; Indexing allowed: Có
Chứng minh Googlebot trực tiếp tải được file sitemap ngon lành tại thời điểm đó và không bị tường lửa hay robots.txt chặn
4. Kiểm tra URL Inspection cho Trang chủ
Hiển thị “URL nằm trên Google” và “Trang đã lập chỉ mục”
Xác nhận trang chủ đã nằm trong chỉ mục tìm kiếm (nhưng không đại diện cho mọi bài viết con)
5. Báo cáo Sitemaps ngay sau khi vừa nộp đầu giờ chiều
Hiển thị tạm thời Couldn’t fetch (Không thể tìm nạp); kiểu Unknown; 0 URL; chưa ghi nhận ngày đọc cuối
Hiện tượng rất phổ biến ngay lúc mới bấm Submit khi tiến trình xử lý nền của báo cáo Sitemaps chưa cập nhật xong
6. Rà soát lại lúc khoảng 17:41 chiều cùng ngày
Sơ đồ tổng chuyển sang Thành công (Success); ngày đọc 02/10; ghi nhận 8 URL được khám phá
Google đã đọc xong file sitemap tổng, nhưng bắt buộc phải bấm vào bên trong để xem trạng thái từng sitemap con
7. Chi tiết 4 Sitemap con lúc 17:41
Nhóm pages: Thành công (6 URL); nhóm category: Thành công (2 URL); riêng nhóm posts và users vẫn báo Không thể tìm nạp (0 URL)
Cho thấy quá trình thu thập các sơ đồ con diễn ra bất đồng bộ (asynchronous), chưa hoàn tất cùng một lúc
8. Chạy Live Test cho Sitemap posts (17:43:09) và users (17:43:55)
Cả hai đường dẫn đều báo: Crawl allowed: Có; Fetch: Thành công; Index allowed: Có
Chứng minh hai file XML con hoàn toàn khỏe mạnh và Googlebot đọc được trực tiếp, không hề có lỗi cấu hình máy chủ
9. Rà soát tổng kết lúc 18:13 chiều ngày 02/10
Sơ đồ tổng báo Thành công (12 URL); cả 4 sitemap con đều báo Thành công xanh mướt (pages: 6, posts: 3, category: 2, users: 1)
Hệ thống Google đã hoàn tất việc đọc và xử lý toàn bộ cây sơ đồ trang web mà không cần can thiệp sửa đổi gì thêm
Kinh nghiệm thực chiến cực kỳ quý giá từ diễn biến buổi chiều ngày 02/10: Rất nhiều anh em quản trị web vừa bấm nút Submit Sitemap xong thấy bảng báo cáo hiện dòng chữ đỏ chót Couldn’t fetch (Không thể tìm nạp) là tá hỏa tưởng web bị lỗi, vội vàng lao vào cài lại plugin SEO, sửa robots.txt loạn xạ hoặc bấm Submit lại hàng chục lần! Qua bảng nhật ký thực tế trên, bạn có thể thấy rõ sự khác biệt giữa 3 tầng xử lý của Google: (1) tiếp nhận yêu cầu nộp, (2) khả năng kết nối trực tiếp tức thời qua Live Test, và (3) tiến trình xử lý nền cập nhật lên bảng báo cáo Sitemaps. Lúc 14:26, dù bảng báo cáo ghi Couldn’t fetch nhưng công cụ Live Test khẳng định Google tải được file XML hoàn toàn bình thường. Đến 17:41, sơ đồ tổng và 2 sơ đồ con chuyển sang Thành công (khám phá 8 URL), còn 2 sơ đồ con chờ tới 18:13 cũng tự động chuyển sang Thành công trọn vẹn với tổng cộng 12 URL được khám phá (khớp tuyệt đối 100% với con số 6 trang tĩnh + 3 bài viết + 2 chuyên mục + 1 tác giả trong file XML thực tế!). Xem thêm tài liệu giải thích của Google tại Báo cáo Sitemaps và Công cụ URL Inspection.
Tất nhiên, cách xử lý của một kỹ sư điềm tĩnh lúc 17:41 không phải là ngồi khoanh tay đoán mò rằng “chắc do Google chậm thôi”, mà là thực hiện kiểm chứng kỹ thuật bài bản: chúng tôi dùng curl và bộ phân tích XML kiểm tra phản hồi công khai của cả hai file posts và users (đều trả về HTTP 200, XML chuẩn, không bị chặn header), sau đó chạy Live Test trực tiếp trong GSC lúc 17:43 để khẳng định 100% phía máy chủ localhost.vn không có lỗi. Khi đã cầm chắc bằng chứng kỹ thuật rằng hệ thống của mình hoàn toàn chuẩn chỉ, phương án đúng đắn nhất là giữ nguyên hiện trạng và kiên nhẫn chờ Google đồng bộ xong, tuyệt đối không đập phá cấu hình đang chạy tốt. (Lưu ý thêm trên tài sản localhost.vn còn lưu vết 13 đường dẫn sitemap lịch sử từ giai đoạn tháng 01/2021; chúng tôi tách biệt hoàn toàn dữ liệu lịch sử đó và không cộng dồn vào kết quả của hệ thống WordPress mới).
Một khi cả 4 nhánh sơ đồ con đã báo Thành công và ghi nhận đủ 12 URL được khám phá (Discovered URLs), công việc tiếp theo trong những tuần tới là theo dõi quá trình Googlebot đi vào từng URL đó để thu thập nội dung và đưa vào chỉ mục tìm kiếm thực tế.
Tài liệu tham khảo chính thức và hành trình tiếp theo
Mời bạn xem lại tổng thể lộ trình cài đặt và vận hành WordPress trên VPS từ A đến Z. Bài viết trước: Kiểm thử Form liên hệ và thông báo quản trị WordPress trước ngày ra mắt. Bài viết tiếp theo: Checklist vận hành ngày đầu sau ra mắt: Sao lưu (Backup), phân quyền, cập nhật và diễn tập Rollback.
Quy trình 6 bước chuyển website WordPress về CloudFly (Cloud Hosting & VPS) không gián đoạn: hạ DNS TTL, test ngầm bằng hosts file và săn mã giảm tới 70%.
Hướng dẫn kiểm thử form WordPress từ bước nhập liệu, lưu trữ Flamingo, cấu hình Reply-To đến xử lý lỗi gửi mail và thông báo quản trị trước khi ra mắt.
Chào bạn! Web đang dính mã độc, tự nhảy trang lạ hay chạy ì ạch? Chọn nhanh triệu chứng bên dưới — hệ thống sẽ tự động chép sẵn phiếu khám và mở thẳng khung chat Zalo kỹ thuật cho bạn.
1. Chọn hạng mục cần hỗ trợ:
Nội dung sẽ tự động chép khi bấm gửi:
Quét mã từ Zalo điện thoại
Nếu bạn đang ngồi máy tính chưa cài Zalo PC, hãy mở ứng dụng Zalo trên điện thoại và quét mã này để chat trực tiếp với kỹ thuật viên.